

 Tiếng Việt
 English
 简体中文

NVIDIA Tesla V100 từng là lựa chọn phổ biến trong các hệ thống AI, nhưng khi áp dụng vào bài toán chạy LLM local, nhiều giới hạn bắt đầu xuất hiện. Trong quá trình test với một số model phổ biến, mình nhận thấy các model nhỏ vẫn hoạt động ổn, nhưng từ 13B trở lên thì hiệu năng giảm rõ rệt, đặc biệt do giới hạn VRAM. Bài viết này sẽ tập trung phân tích các yếu tố kỹ thuật chính để đánh giá khả năng đáp ứng thực tế của V100
🚀 NVIDIA Tesla V100 vẫn là GPU đáng cân nhắc cho Local LLM nhờ cân bằng tốt giữa hiệu năng, VRAM và chi phí tiếp cận
- 💾 VRAM 16GB / 32GB + HBM2 (~900 GB/s) giúp xử lý model lớn ổn định, hạn chế nghẽn dữ liệu khi inference
- ⚡ Hiệu năng thực tế (Tokens/s): đạt ~84.6 tokens/s với Llama 3.1 8B và có thể scale multi-GPU để chạy model 70B – 120B
- 🔗 NVLink 2.0 cho phép mở rộng đa GPU, hỗ trợ xử lý các mô hình LLM lớn vượt giới hạn một card đơn
- ⚠️ Hạn chế: kiến trúc Volta dần bị giới hạn hỗ trợ CUDA mới và không tương thích Flash Attention
- 🔋 Hiệu quả điện năng tốt: tiêu thụ thực tế ~175W khi chạy LLM, phù hợp vận hành lâu dài
👉 Tổng thể, V100 vẫn là lựa chọn tối ưu chi phí cho Local LLM, nhưng cần cân nhắc nếu hướng đến các công nghệ AI mới trong tương lai.
1. Tìm hiểu về dòng Card Nvidia V100
Khi nhắc đến các GPU đặt nền móng cho AI hiện đại, NVIDIA Tesla V100 là một trong những cột mốc quan trọng. Ra mắt năm 2017 bởi NVIDIA, dòng GPU này đã đưa kiến trúc đồ họa rời từ vai trò hỗ trợ sang trung tâm của các hệ thống AI và tính toán hiệu năng cao (HPC).
Cấu hình kỹ thuật cốt lõi của NVIDIA Tesla V100:
- Kiến trúc: Volta (tối ưu cho AI)
- Tiến trình: 12nm FinFET
- CUDA Cores: 5120
- Tensor Cores: 640 (thế hệ 1 – tăng tốc tính toán ma trận)
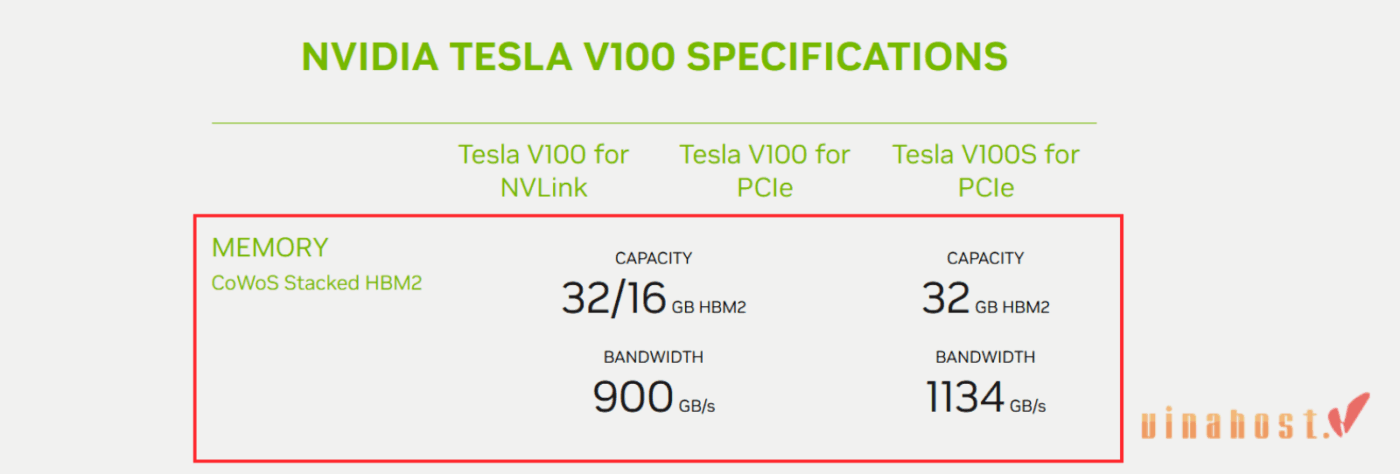
- VRAM: 16GB / 32GB HBM2
- Băng thông bộ nhớ: ~900 GB/s (Vượt xa con số 484 GB/s của GTX 1080 Ti cùng thời)
- Hiệu năng FP32: 15.7 TFLOPS
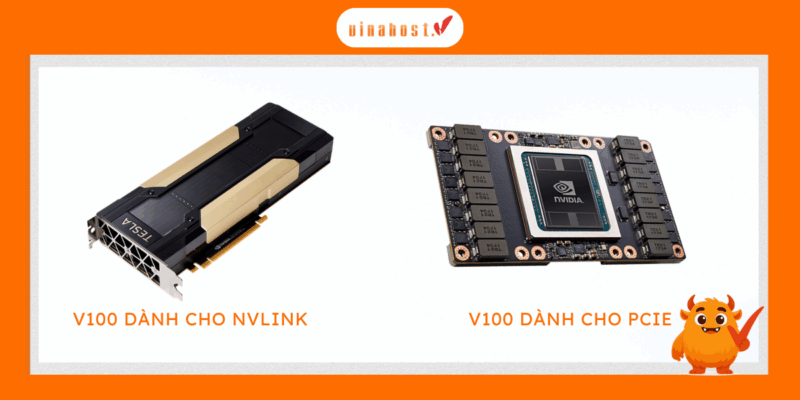
- Giao tiếp: PCIe / SXM2
- NVLink: Có hỗ trợ
- TDP: 250W – 300W
✅ Khai phá sức mạnh tính toán vượt trội với card NVIDIA Tesla V100 – giải pháp hoàn hảo về cả hiệu năng lẫn chi phí: Tùy chọn linh hoạt từ VPS GPU AI tiết kiệm chi phí đến Dedicated Server GPU độc quyền tài nguyên phần cứng. Liên hệ VinaHost ngay để trải nghiệm và tối ưu hạ tầng AI.
2. Tại sao V100 vẫn còn được sử dụng đến hiện tại
NVIDIA Tesla V100 không còn là GPU mới, nhưng vẫn được sử dụng rộng rãi trong Local LLM vì đáp ứng tốt bài toán chi phí – hiệu năng – khả năng triển khai. Đây không phải lựa chọn tối ưu nhất, nhưng là lựa chọn hợp lý trong nhiều trường hợp thực tế.
2.1 Tính có sẵn trên thị trường
V100 hiện có nguồn cung lớn trên thị trường phần cứng đã qua sử dụng, chủ yếu từ các hệ thống data center và HPC nâng cấp. Điều này giúp người dùng dễ tiếp cận hơn so với các GPU AI thế hệ mới.
- Nguồn hàng dồi dào, dễ tìm mua
- Giá giảm mạnh so với thời điểm ra mắt
- Phù hợp cho cá nhân hoặc hệ thống nhỏ triển khai Local LLM
Thực tế, đây là lý do quan trọng nhất khiến V100 vẫn còn phổ biến.
2.2 Dung lượng VRAM cao
V100 vẫn có lợi thế rõ ràng về VRAM trong phân khúc giá, đặc biệt với phiên bản 32GB. Với Local LLM, dung lượng bộ nhớ quyết định trực tiếp khả năng chạy model.
- 16GB / 32GB đủ cho các model 7B – 13B và có thể mở rộng với quantization
- Bộ nhớ HBM2 với băng thông cao (~900 GB/s) giúp giảm nghẽn khi xử lý dữ liệu lớn
- Ổn định hơn so với GPU gaming cùng tầm giá khi chạy context dài
Điểm mạnh của V100 không chỉ là dung lượng, mà là cách nó xử lý dữ liệu.
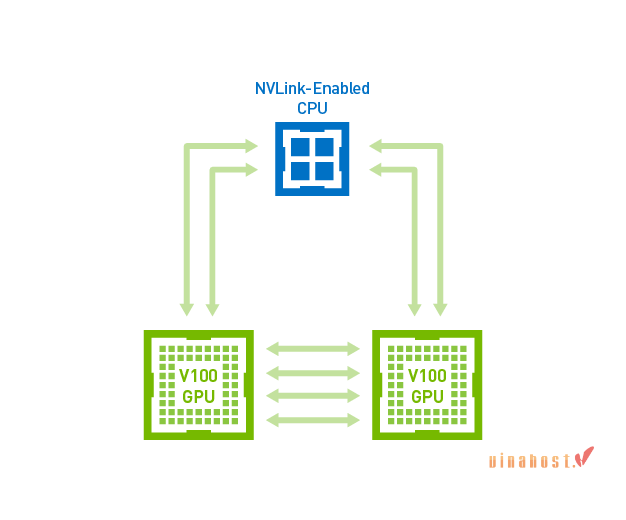
2.3 Kết nối NVLink 2.0
Một lợi thế khác là khả năng mở rộng đa GPU thông qua NVLink 2.0, điều mà GPU phổ thông khó đáp ứng.
- Băng thông kết nối cao (~300 GB/s), nhanh hơn PCIe
- Cho phép chia tải model trên nhiều GPU (model parallelism)
- Phù hợp khi triển khai các model lớn (>30B)
Tuy nhiên, hiệu quả của NVLink phụ thuộc vào hệ thống và không phải lúc nào cũng cần thiết với nhu cầu nhỏ.
3. Phân tích chi tiết thông số kỹ thuật và hiệu năng
Hiệu năng của NVIDIA Tesla V100 khi chạy Local LLM không nằm ở thông số lý thuyết, mà thể hiện qua ba yếu tố chính: kiến trúc, băng thông bộ nhớ và tốc độ sinh token.
3.1 Kiến trúc Volta và băng thông bộ nhớ
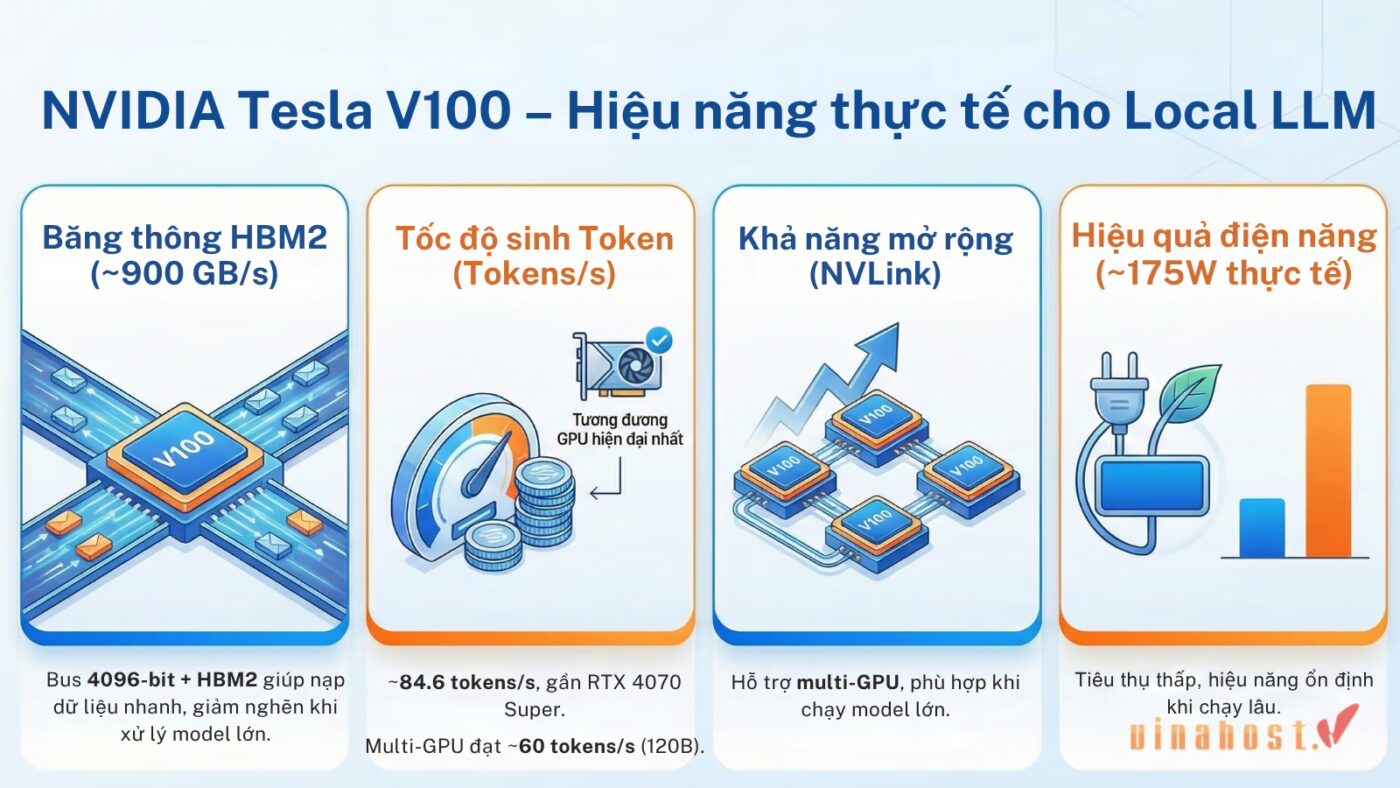
V100 sử dụng giao diện bộ nhớ 4096-bit kết hợp HBM2, cho băng thông khoảng 900 GB/s. Đây là điểm khác biệt rõ so với GPU dùng GDDR.
- Băng thông cao giúp dữ liệu (weights, tensor) được nạp nhanh vào GPU
- Giảm tình trạng nghẽn khi xử lý model lớn hoặc context dài
- Giữ hiệu năng ổn định hơn trong quá trình inference
Với LLM, băng thông bộ nhớ quan trọng không kém số nhân. V100 làm tốt phần này, nên dù cũ vẫn còn giá trị.
3.2 Đo lường tốc độ sinh Token (Tokens/s)
Hiệu năng thực tế của NVIDIA V100 thể hiện rõ qua tốc độ sinh token, đặc biệt khi so sánh theo benchmark.
- Theo MLPerf, Llama 3.1 8B đạt ~84.6 tokens/giây, gần tương đương RTX 4070 Super (~88.6 tokens/giây)
- Với model lớn, 4 GPU V100 đạt ~14.5 tokens/giây trên Llama 3.3 70B
- Trong cấu hình tối ưu, hệ thống multi-GPU có thể đạt ~60 tokens/giây với GPT-OSS 120B
Hiệu năng của NVIDIA V100 không nổi bật ở cấu hình đơn, nhưng khi scale đa GPU thì vẫn cạnh tranh trong phân khúc.
3.3 Tối ưu hóa năng lượng tiêu thụ
Ngoài hiệu năng, V100 cho thấy mức tiêu thụ điện tương đối hiệu quả trong thực tế.
- Khi chạy LLM ở tải cao, mức tiêu thụ thực tế khoảng ~175W
- Thấp hơn đáng kể so với nhiều GPU tiêu dùng cao cấp (~475W)
- Giữ hiệu suất trên mỗi watt ở mức ổn định
V100 không phải GPU tiết kiệm điện nhất, nhưng hiệu quả điện năng trên hiệu năng vẫn ở mức hợp lý, đặc biệt khi chạy liên tục.
4. Một số hạn chế về công nghệ và phần mềm
Bên cạnh hiệu năng, NVIDIA Tesla V100 bắt đầu bộc lộ giới hạn về kiến trúc và khả năng hỗ trợ phần mềm. Đây là những yếu tố ảnh hưởng trực tiếp nếu triển khai Local LLM trong dài hạn.
4.1 Khả năng tương thích kiến trúc CUDA
Kiến trúc Volta (Compute Capability 7.0) của NVIDIA V100 đang dần đi đến cuối vòng đời hỗ trợ.
- Volta dự kiến EOL vào tháng 10/2025 và không còn xuất hiện trong CUDA 13
- Hệ thống sử dụng V100 sẽ phải duy trì trên các phiên bản cũ như CUDA 11.8
- Khó tiếp cận các tối ưu và tính năng mới từ framework hiện đại
NVIDIA V100 vẫn chạy được, nhưng về lâu dài sẽ bị “đóng khung” trong hệ sinh thái cũ. Đây là hạn chế rõ nếu bạn cần cập nhật công nghệ liên tục.
4.2 Sự thiếu hụt tính năng Flash Attention
Một hạn chế kỹ thuật khác là NVIDIA V100 không hỗ trợ Flash Attention ở cấp độ phần cứng.
- Flash Attention giúp giảm truy cập bộ nhớ và tăng tốc xử lý attention trong LLM
- Kiến trúc Volta không đáp ứng đầy đủ yêu cầu để khai thác tối ưu kỹ thuật này
- Khi xử lý context dài, V100 tiêu tốn nhiều VRAM hơn và tốc độ suy luận thấp hơn so với GPU thế hệ mới
Với các model LLM hiện đại (context lớn), việc thiếu Flash Attention là bất lợi rõ ràng. Tuy nhiên, với các model nhỏ hoặc đã tối ưu, ảnh hưởng này vẫn ở mức chấp nhận được.
5. Kết luận
NVIDIA Tesla V100 vẫn là một lựa chọn đáng cân nhắc trong bài toán triển khai Local LLM, nhờ sự cân bằng giữa hiệu năng, dung lượng VRAM và chi phí tiếp cận. Dù không còn là GPU tối ưu nhất cho các công nghệ mới như Flash Attention hay các framework hiện đại, NVIDIA V100 vẫn đáp ứng tốt nhu cầu với các model tầm trung khi được tối ưu hợp lý.
Tuy nhiên, với những hạn chế về kiến trúc và lộ trình hỗ trợ phần mềm, việc lựa chọn NVIDIA V100 nên được cân nhắc dựa trên mục tiêu sử dụng và kế hoạch dài hạn. Nếu bạn cần một giải pháp hiệu quả về chi phí cho Local LLM, NVIDIA V100 vẫn là một nền tảng đáng để đầu tư.
Để theo dõi thêm nhiều bài viết mới nhất của VinaHost, bạn có thể truy cập blog TẠI ĐÂY. Hoặc nếu bạn muốn được tư vấn thêm thì có thể liên hệ với chúng tôi qua:
- Email: cskh@vinahost.vn
- Hotline: 1900 6046 phím 1
- Livechat: https://livechat.vinahost.vn/chat.php
Xem thêm một số bài viết khác:
- GPU server là gì? Phân biệt máy chủ GPU và CPU
- Máy Chủ GPU NVIDIA A100: Giải Pháp AI/HPC Tối Ưu
- Card màn hình Nvidia Quadro RTX A2000 – Đánh giá hiệu suất chi tiết
- Máy Chủ GPU NVIDIA T4 Tensor Core: Giải Pháp Tối Ưu Cho AI Inference
- NVIDIA Tesla P40 24GB: GPU Inference Siêu Mạnh Cho AI & Video
- Các thành phần của Phần cứng máy chủ và Cách hoạt động
- Máy Chủ GPU NVIDIA H100 Tensor Core: Hướng Dẫn Toàn Diện


Mình là Ngô Thị Yến, sở hữu hơn 1 năm kinh nghiệm viết về lĩnh vực như: Cloud Server, VPS, hosting, domain,.. Mục tiêu của mình là mang đến cho người đọc những nội dung chất lượng, giá trị và dễ dàng tiếp cận giúp bản thân mình có thể xây dựng lòng tin từ cộng đồng người dùng tại VinaHost.

 Tên miền miễn phí
 Hosting
 SEO Hosting
 VPS
 VPS Giá Rẻ
 VPS Cao Cấp
 VPS NVMe
 VPS AMD
 VPS MMO
 VPS Minecraft
 VPS ARK
 VPS RUST
 VPS Forex
 VPS N8N
 VPS GPU
 VPS Philippines
 Server
 Cloud
 Private Cloud
 Alibaba Cloud
 Email
 Email Marketing
 Hybrid Email
 Network
 Web



